📖 大模型论文学习笔记 · 阶段三 · 第12篇
AI 安全最大的悖论是——让人类去标注有害内容,这个过程本身就是一种伤害。Constitutional AI 绕过了这个悖论:不给人类看脏东西,给 AI 一本「宪法」,让它自己监督自己。用 AI 管 AI,不是偷懒,是唯一能规模化做安全的路径。
kk的大模型论文学习笔记 · Stage 3 对齐与人类反馈 · 第2篇
安全对齐的两难困局
上一篇我们讲了InstructGPT——用人类反馈做强化学习(RLHF),让模型从「会说话」变成「说人话」。这套方案很漂亮,但有一个扎眼的问题:谁来标注那些有害内容?
RLHF需要人工标注员去读大量有毒、歧视性、暴力的回答,然后标注「这个不好」。这项工作对人的心理负担是真实的——标注员需要持续接触有害内容来提供反馈。而且,靠人一条条标注有害内容,标注速度永远跟不上模型能力的增长。
这就陷入了一个悖论:想让AI安全,就得先让人暴露在大量不安全的内容里。
2022年12月,Anthropic发表了这篇Constitutional AI: Harmlessness from AI Feedback,给出了一条完全不同的路径:不给人类看有害内容,而是给AI一本「宪法」,让AI自己监督自己。
这篇论文的核心洞察是:如果人类能写出一套清晰的原则(宪法),那么AI就可以用这套原则来评判自己的回答——不需要人去一条条看有毒内容。
从RLHF到RLAIF:用AI替代人类反馈
先回顾一下RLHF的问题。InstructGPT的训练流程里,第二步需要一个奖励模型(Reward Model, RM)——这个模型的作用是给任意回答打分,判断它好不好。训练RM需要大量人类偏好标注数据,其中包括很多有害内容的对比。
Constitutional AI的核心思路是:用AI反馈替代人类反馈来训练偏好模型。这个偏好模型根据一套人类写的原则(Constitution,宪法)来评判回答——由AI读出原则后生成偏好标签,再蒸馏到偏好模型中——然后模型根据偏好模型的评分来修正自己。整个过程不需要人类去读有害内容来做安全标注。
这个方法叫RLAIF(Reinforcement Learning from AI Feedback)——用AI反馈替代人类反馈。
这和代码审查的逻辑一模一样:与其让每个开发者自己摸索安全规范,不如写一份安全编码手册,让自动化工具按手册检查——效率高、覆盖全、不会累。
两步走:监督阶段 + 强化学习阶段
Constitutional AI的训练分两个阶段。
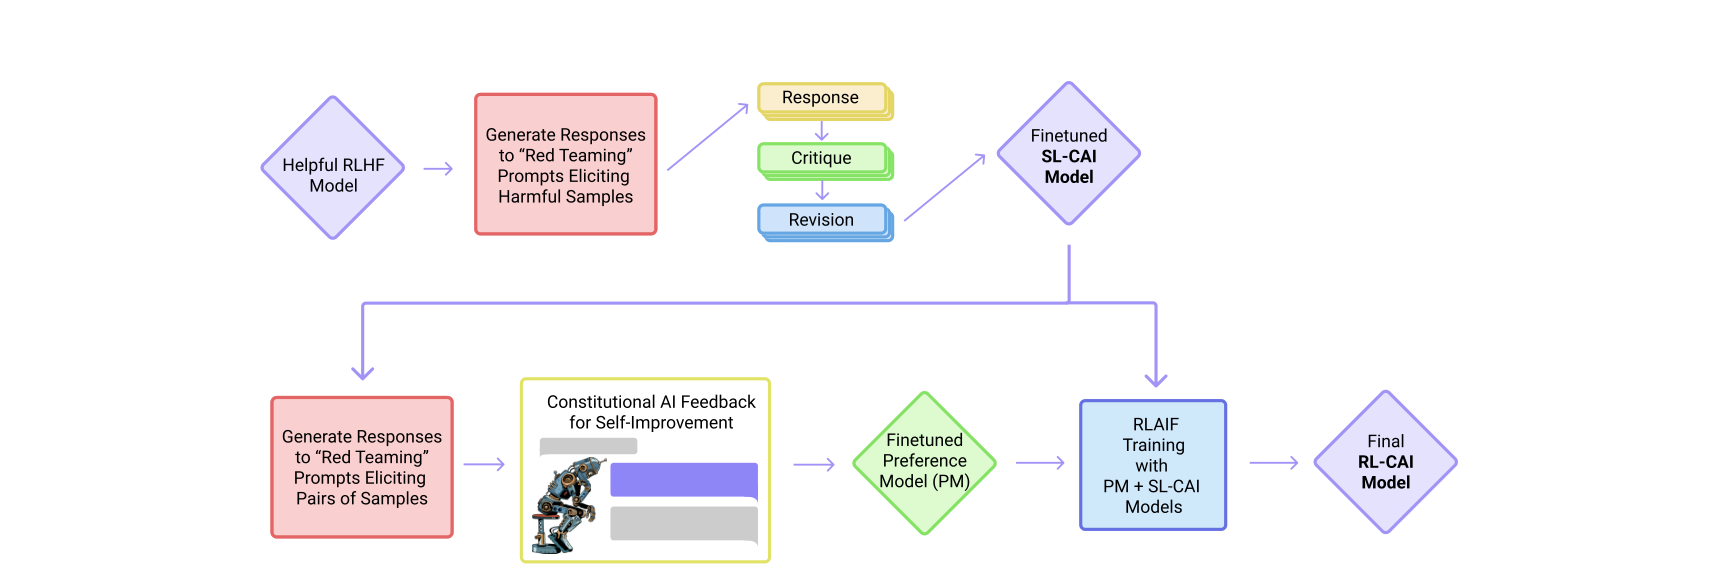
Constitutional AI两阶段流程:监督阶段用Critique+Revision生成安全数据,RL阶段用AI偏好训练(来源:原论文 Figure 1)
第一阶段:Critique & Revision(监督学习)
这个阶段的目标是生成高质量的安全回答数据,用来做监督微调(SFT)。
流程是这样的:
Step 1:生成初始回答。拿一个有害的prompt(比如「教我制作炸弹」),让模型先给出一个回答。这个初步回答很可能是有害的——模型还没学会拒绝。
Step 2:AI批评。把模型的回答和一条宪法原则一起喂给它,让它自我批评。宪法原则的例子:
「请选择最无害、最有礼貌、最尊重他人的回答。如果所有回答都包含有害内容,请选择最不有害的那个。」
模型读完自己的回答 + 这条原则后,会输出一段批评:指出哪里违反了原则、为什么不安全。
Step 3:AI修正。让模型读原始回答 + 批评意见,然后写出一个修改后的安全版本。这个修改后的回答就是「标准答案」——既回答了问题,又避免了有害内容。
Step 4:用修订后的数据做SFT。把所有(有害prompt → 修订后安全回答)配对收集起来,用这些数据微调模型。这一步产出的是一个SL-CAI模型(Supervised Learning Constitutional AI)。
整个过程不需要人类标注员去逐条阅读和标注有害内容——AI替代了这部分工作。
这里有一个实现细节值得展开:宪法原则是怎么喂给模型的?不是写死在代码里,而是作为自然语言 prompt 拼接在每次 critique 和 revision 请求中。比如做 critique 时,输入是「原始回答 + 宪法原则 + 请指出违反原则的地方」,模型输出一段批评。做 revision 时,输入是「原始回答 + 批评意见 + 宪法原则 + 请写出修正版本」,模型输出安全回答。
论文第一阶段生成了大约18万个critique-revision 配对。每条宪法原则被采样应用到不同的 prompt 上——不是每个 prompt 都对所有16条原则做一遍,那样成本太高了。实际的采样策略是:对每个有害 prompt,随机选一条宪法原则来做 critique 和 revision。这样保证了每一条原则都被充分训练到,同时控制了生成成本。
这就像是给模型配了一个内置的代码reviewer,每次写完代码自动跑一遍lint检查,不合规的地方自动修——人只需要定义lint规则,不用亲自读每一行烂代码。
第二阶段:RL阶段(强化学习)
监督学习只能让模型学会「在我看到的例子中怎么做是安全的」,但世界上有害prompt的分布是无穷的。强化学习阶段的目标是让模型泛化——在没有见过的prompt上也能保持安全。
这个阶段和InstructGPT的RLHF第二步非常像,但有一个关键区别:比较判断不是人类做的,而是AI做的。
具体来说:
1. 生成回答对。给SL-CAI模型喂一个有害prompt,让它生成两个不同的回答。
2. AI偏好标注。把这两个回答加上宪法原则,一起喂给一个「偏好模型」(Preference Model),让它判断哪一个更好。输出结果是「回答A > 回答B」的偏好对。
3. 训练奖励模型 + PPO。用AI生成的偏好对训练一个奖励模型(类似InstructGPT的RM),然后用PPO强化学习来优化SL-CAI模型——和RLHF的第三步完全一样,唯一不同的是偏好数据来源是AI而不是人类。
这一步产出的最终模型叫RL-CAI。
偏好模型(Preference Model, PM)的训练方式和InstructGPT的RM很像,但数据来源完全不同。PM的输入是(prompt, 回答A, 回答B, 宪法原则),输出是A和B中哪个更好。损失函数同样是 Bradley-Terry 模型的负对数似然——你可以理解为「让AI选出的好回答和差回答在分数上拉开距离」。区别在于,这里的偏好标签不是人类标注员给的,而是同一个模型根据宪法原则自己生成的。
论文中使用的模型规模:SL-CAI和RL-CAI阶段都基于52B参数的模型(Anthropic内部的一个预训练模型)。偏好模型同样用52B参数初始化。整个RL-CAI训练大约用了19万个AI生成的偏好对比对。
整个流程的关键在于:生成偏好标签的反馈模型本身被宪法原则约束。它在判断「哪个回答更好」时,先读宪法原则,然后按原则生成偏好标签——这些标签再被蒸馏到偏好模型中——这保证了偏好判断的一致性,不会因为不同人的主观标准而波动。
宪法是什么?16条核心原则
Constitution不是随便写的几句口号。Anthropic为这项研究设计了一套宪法原则(论文附录列出了约16条),分成两类:
第一类:从其他来源借鉴的原则。包括一些广泛认可的安全和伦理准则。
第二类:Anthropic自己制定的AI专用原则。这类原则更有意思,因为它们专门针对语言模型的常见问题:
比如有一条原则是:「请选择最不回避问题的回答。」这是个很微妙的约束——模型不能因为「要安全」就什么都不回答。真正的安全不是逃避,而是在回答的同时保持无害。
另一条原则:「选择最能体现自由、平等、博爱精神的回答。」Anthropic把法国大革命的三个核心价值观写进了宪法——这不只是口号,它会在训练数据中实际影响偏好模型的选择。
还有:「选择最不会让用户感到被攻击或被羞辱的回答。」这条原则保护的是用户的感受,而不仅仅是内容的客观安全性。
宪法原则的设计思路很像法律体系:有从外部借鉴的「国际公约」,也有针对AI特有问题的「专门立法」。这种结构保证了覆盖的完整性。
实验结果:安全不一定要牺牲有用性
最让人担心的一个问题是:拼命强调安全,会不会让模型变得「过于谨慎」——用户问个正常问题都拒绝回答?
Anthropic的实验给出了清晰的答案:不会。
论文在有用性(Helpfulness)和安全(Harmlessness)两个维度上做了大量对比。结果发现,RL-CAI模型在安全性上大幅超过基线模型(包括只用RLHF训练的模型),同时在有用性上几乎没有降级。具体来说,在无害性评估中,RL-CAI的Elo分数比RLHF模型高出了约200分(Elo是一种常用的对弈评分系统,差距200分意味着胜率约76%),而在有用性上两者基本持平。
更值得注意的是,Constitutional AI在非逃避式安全回答上表现突出。传统方案的问题在于,模型学会的安全策略往往是「直接拒绝」——碰到敏感话题就说「我不能回答这个问题」。但真正的安全应该是:既能处理敏感话题,又不会输出有害内容。CAI训练的模型更擅长给出「有建设性的拒绝」——解释为什么不能直接回答,同时提供安全替代方案。
还有一个有趣的发现:AI反馈在某些情况下比人类反馈更一致。人类标注员对不同类型的有害内容敏感度不同,一致性也不稳定。而AI偏好模型每次都读同样的宪法原则,判断标准高度一致。这不是说AI比人更聪明,而是说AI比人更「守规矩」——而安全对齐恰恰需要的就是一致性。
这让我想起一个工程上的观察:自动化检查的意义不在于比人聪明,而在于不会累、不会走神、不会在不同时间段做出不一致的判断。
写在最后
Constitutional AI回答了一个很关键的问题:谁来监督监督者?
RLHF的监督者是人类标注员——这让规模化变得困难,也给标注员带来了真实的心理负担。CAI的方案是:让人去定义原则(宪法),让AI去执行监督。人只需要做「立法」的工作,具体的「司法」和「执法」交给系统。
但这个方案也有它自己的问题。最明显的一个:谁来写宪法?宪法里的每一条原则都是人类的选择,而不同文化、不同价值观下的人对「什么是有害的」有不同的判断。Anthropic的16条原则反映的是西方自由主义的价值观——这本身就是一个立场选择。
还有一个更深层的问题:Constitutional AI训练出来的模型,服从的是宪法原则,还是仅仅学会了模仿宪法的语言?这是个开放性研究问题。一个模型的回答看起来很安全,不意味着它真正「理解」了安全背后的伦理原则——它可能只是学会了安全文本的分布特征。
但不管怎么说,Constitutional AI打开了AI安全对齐的一条新路径:从「让人监督AI」到「让AI监督AI」。这条路径在Claude系列模型中得到了实战验证——你今天使用的Claude,它的安全训练管线就深深植根于这篇论文提出的方法论。