📖 大模型论文学习笔记 · 阶段一 · 第5篇
2020年5月,OpenAI发表了GPT-3的论文。
1750亿参数。据当时业界估算,训练一次的成本在400万到1200万美元之间。在当时,这是人类训练过的最大的神经网络。
但GPT-3真正震撼行业的不是规模,而是一个更深层的问题:一个只训练了"预测下一个词"这个单一目标的模型,为什么能做这么多不同的事?
它不需要微调。你只需要在输入中给它几个例子,它就能学会新任务。翻译、编程、问答、摘要、创意写作——几乎无所不能。虽然每一样都不一定是最好的,但一个模型做所有事的能力,是前所未有的。
这就是in-context learning(上下文学习),其中few-shot(少样本学习)是其最典型的表现形式。它是GPT-3最重要的发现,也是后来ChatGPT的基础。
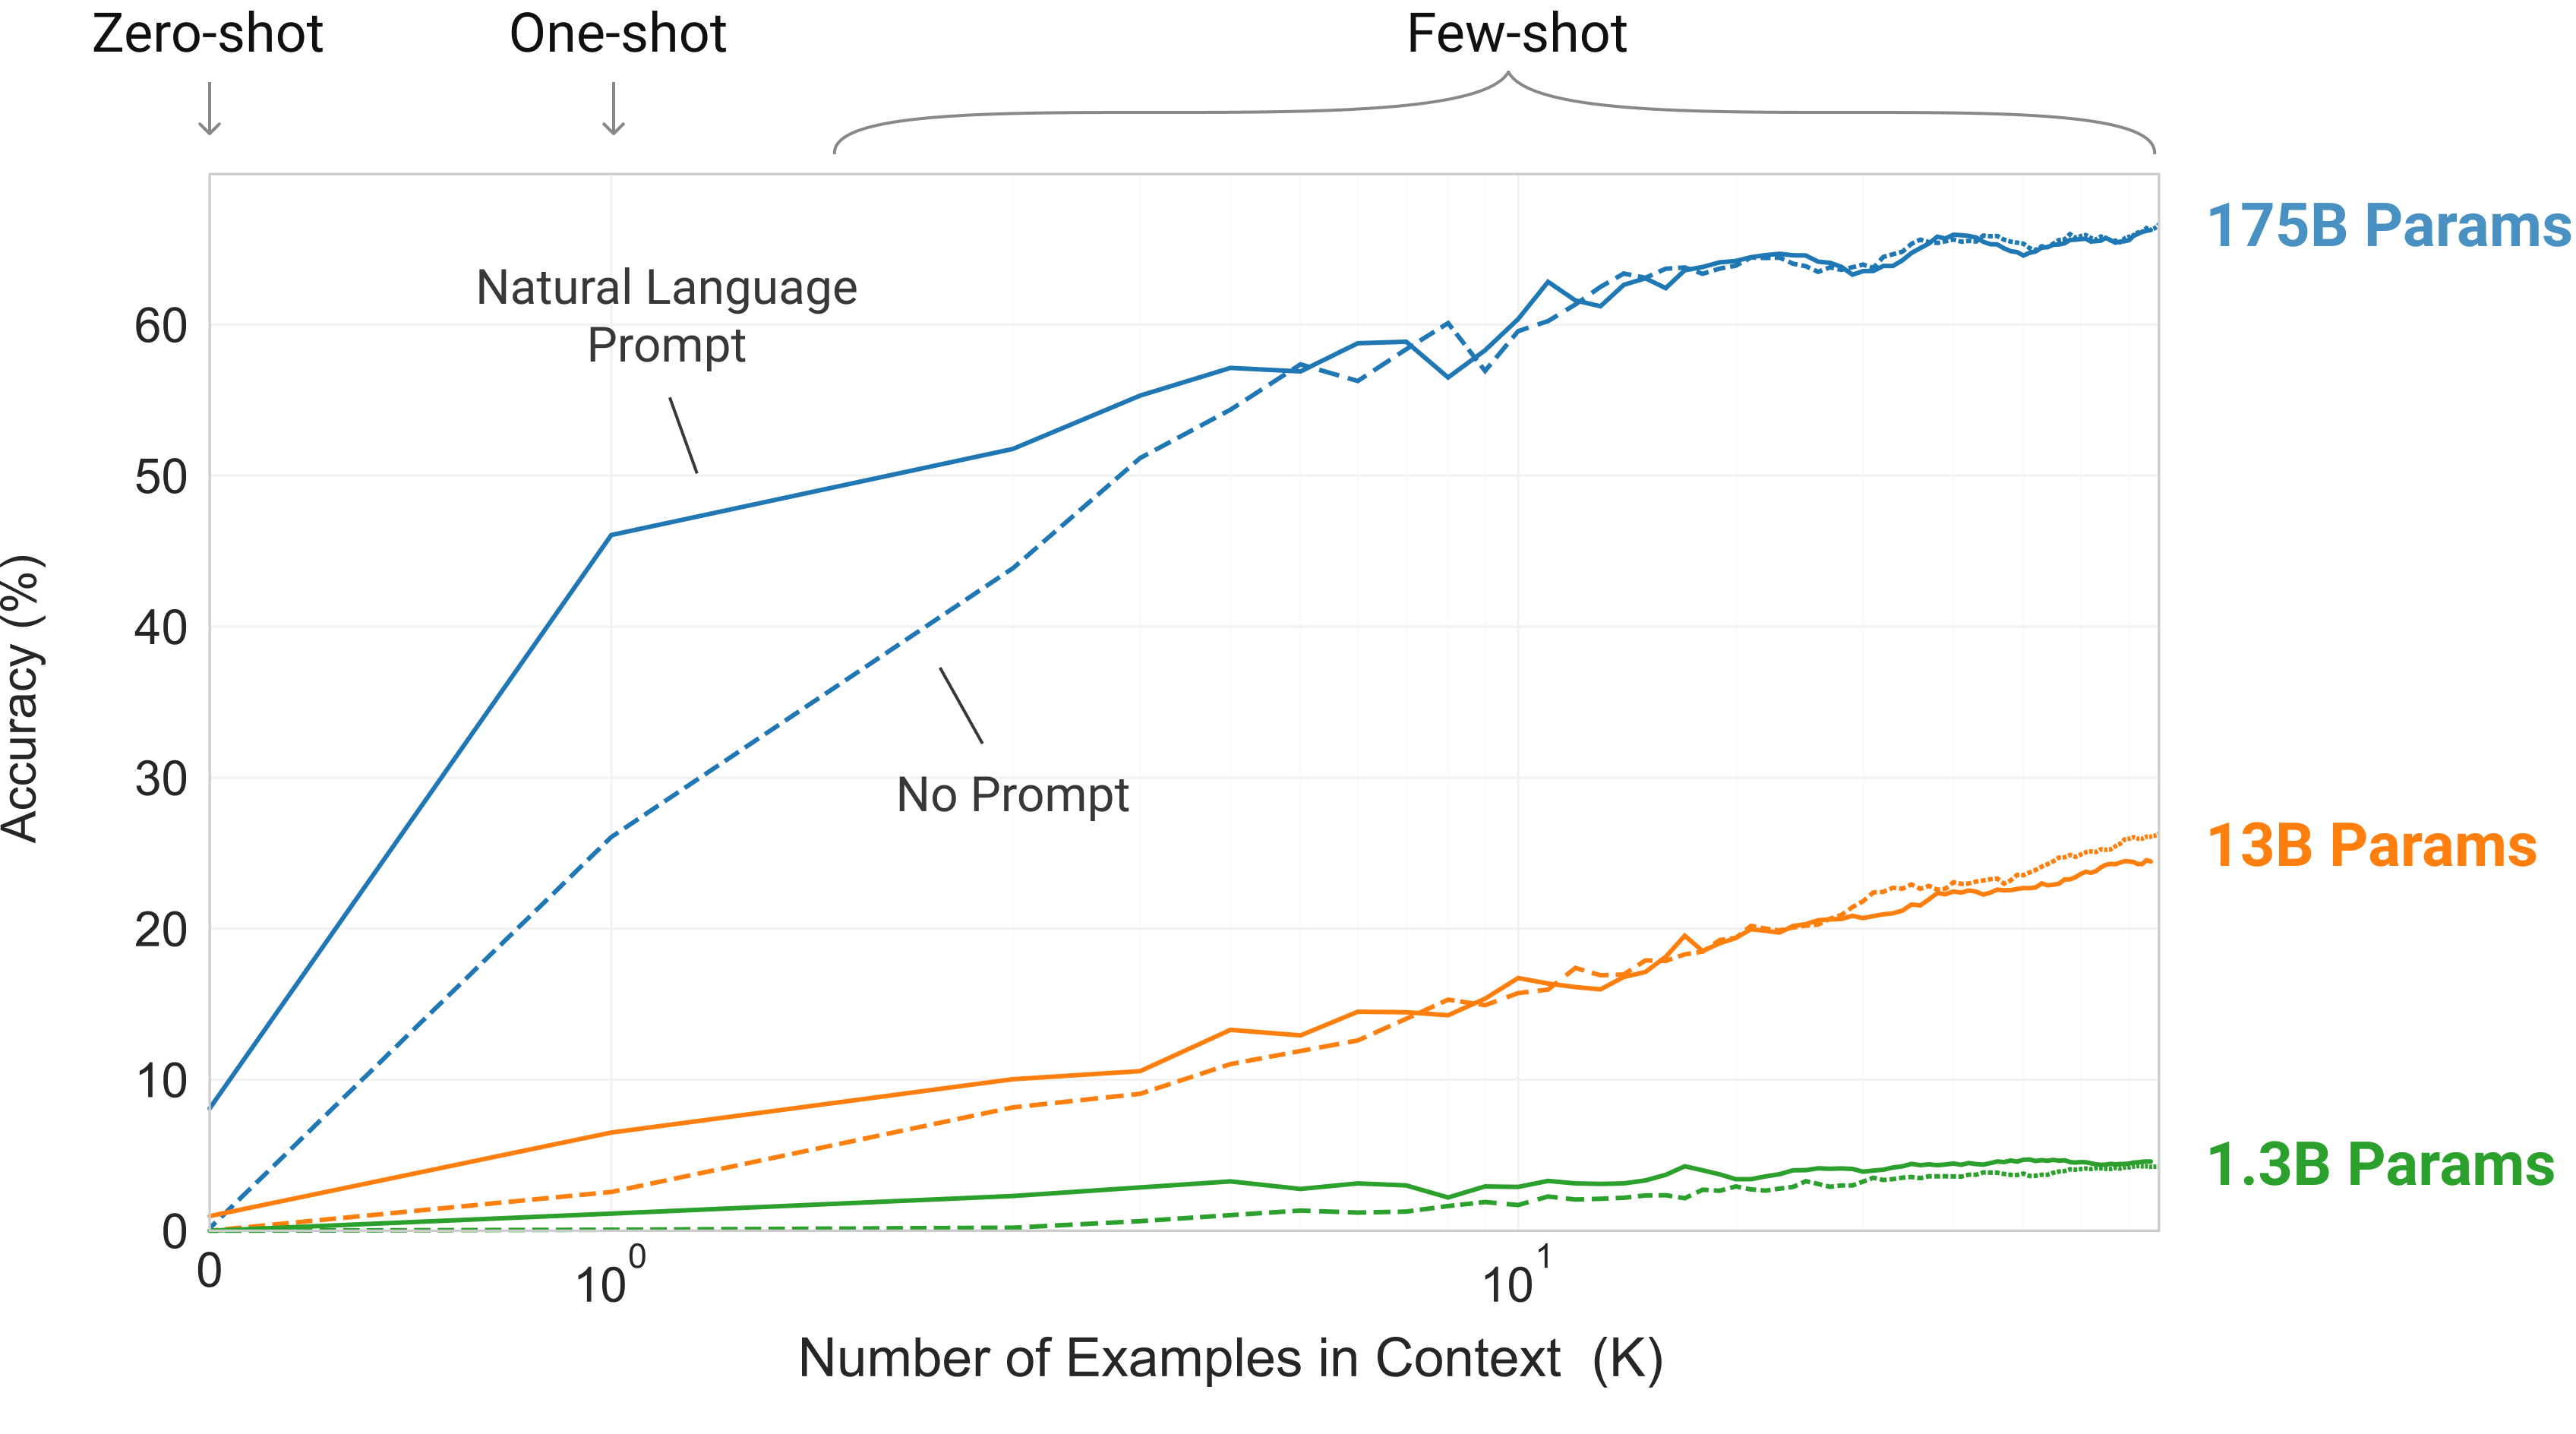
GPT-3的核心能力:不需要重新训练模型,只需要在输入中给出任务描述和几个例子,模型就能直接输出结果。就像给新同事看几个示例,他就能照着做一样——zero-shot不给示例,one-shot给一个,few-shot给几个(来源:原论文Figure 1.2)
一、三种学习方式的本质区别
GPT-3论文比较了三种让模型做任务的方式:
Fine-tuning(微调):用任务的标注数据更新模型参数。这是BERT时代的主流做法。效果好,但每个任务都需要标注数据和重新训练。
Few-shot(少样本):不给模型更新参数的机会,只在输入中给出几个任务示例,让模型直接输出答案。比如给模型看3个英法翻译的例子,然后让它翻译第四句。
Zero-shot(零样本):连示例都不给,只告诉模型"请把以下英文翻译成法语",然后直接让它做。
关键是:few-shot和zero-shot完全不更新模型参数。模型只是"读"了你的示例或指令,就理解了你要它做什么。这跟人类的理解方式很像——你告诉一个人"像这样翻译",他看两三个例子就会了,不需要重新"训练"他的大脑。
这在当时是革命性的。在此之前,大家都认为要让模型做新任务,就必须用标注数据微调。GPT-3说:不需要。
二、涌现:规模带来的质变
GPT-3最引人注目的发现之一是涌现能力(emergent abilities)。
什么是涌现?简单说:小模型做不到的事,大模型突然就能做到了。不是渐进式的提升,而是从"完全不行"到"突然会了"的质变。
论文中的数据清楚地展示了这一点。在许多任务上,当模型从13亿参数增长到1750亿参数的过程中,性能不是线性提升的——而是在某个规模拐点之后突然跳升。
更具体地说:
小模型(1-10亿参数)基本只能做简单的模式匹配,few-shot效果很差。
中等模型(10-100亿参数)开始展现出一些任务理解能力,但稳定性很差。
大模型(100亿以上)在越来越多的任务上展现出可靠的few-shot能力。
1750亿参数的GPT-3,在很多任务上的few-shot表现已经接近甚至超过经过微调的专门模型。
涌现的本质是什么?这是一个至今仍在研究的问题。但目前的主流理解是:当模型足够大、数据足够多时,它学会了更深层的抽象——不只是模式匹配,而是对任务结构的理解。当它看到几个示例时,它能识别出"哦,这是一个翻译任务,模式是输入英文输出法语",然后用学到的知识去执行。
三、Few-shot为什么能work?理解in-context learning
这是GPT-3最核心的问题,也是学术界至今仍在争论的问题。
few-shot为什么能work?模型只是"读"了几个例子,为什么就能做新任务了?
第一种解释:模式识别。模型在训练数据中见过大量"示例-答案"的格式。当你给它几个例子,它识别出这个格式,然后按格式续写。本质上还是在做"预测下一个词",只是你的示例把它引导到了正确的输出模式。
第二种解释:隐式学习。在计算attention的过程中,模型实际上在对你的示例进行某种形式的"学习"。虽然参数没有更新,但attention机制本身提供了一种动态的信息处理能力——它可以临时从示例中提取规律,然后应用到新的输入上。
第三种解释:任务识别。模型不只是识别了格式,而是真正理解了"这是一个什么任务",然后用学到的知识去完成。这要求模型同时具备任务理解和任务执行两种能力。
这三种解释不是互斥的。实际上,in-context learning可能是三者的结合——底层是模式识别,中间是隐式信息处理,顶层是任务理解。随着模型规模增大,更高层次的解释变得越来越合理。
不管机制是什么,few-shot的实用价值是巨大的:它把"使用AI"的门槛降到了零。你不需要数据科学家、不需要标注数据、不需要训练模型。你只需要用自然语言描述任务,给出几个例子,就能得到结果。
四、GPT-3的技术细节:不只是"更大"
GPT-3的架构跟GPT-2基本相同(Transformer解码器 + Pre-LN + Byte-level BPE),但在细节上做了一些调整:
规模。1750亿参数,96层,12288维的隐藏维度,96个注意力头。上下文窗口2048个token。
数据。训练数据约5000亿token,来自过滤后的Common Crawl(60%)、WebText2(19%)、书籍(16%)和维基百科(3%)。数据质量比数量更重要——他们对Common Crawl做了大量过滤工作。
训练稳定性。为了在这么大的规模上稳定训练,他们用了模型并行(把一个模型分布在多台机器上)和混合精度训练。
一个值得注意的细节是数据配比。虽然Common Crawl占了60%的数据量,但他们在采样时对它做了降权——实际训练时,高质量数据(WebText2、书籍、维基百科)被采样的频率比它在数据集中的占比更高。这说明数据质量比数据量更重要,这个洞察后来被Chinchilla论文进一步验证。
五、GPT-3的局限和争议
GPT-3很强大,但不是万能的。论文中坦诚地列出了几个重要局限。
生成质量不稳定。它可以写出看起来不错的段落,但在长文本生成中经常出现自相矛盾、重复、跑题。这是因为它的生成本质上是局部的——每次只看前面的token来预测下一个,缺乏全局一致性。
常识推理能力有限。在需要物理常识或因果推理的任务上,GPT-3经常犯错。它学到了很多模式,但不一定真正"理解"了背后的物理世界。
偏见问题。训练数据来自互联网,不可避免地包含各种偏见。GPT-3会无差别地复现这些偏见。
成本和准入。GPT-3的训练成本极高,而且OpenAI没有开源模型权重(只提供了API访问)。这引发了关于AI民主化的讨论——如果只有少数公司能训练大模型,AI的未来由谁决定?
这些局限直接催生了后来的改进方向:RLHF(通过人类反馈来提升生成质量和安全性)、更大的数据规模、更好的数据质量。但核心架构——Transformer解码器 + 预测下一个词——没有变。
六、GPT-3改变了什么?
GPT-3的影响是分层的。
技术层面,它证明了in-context learning的可行性。你不需要为每个任务微调模型,只需要在输入中给出任务描述和示例。这个发现直接催生了prompt engineering这个新领域。
行业层面,它引发了"模型即服务"的商业模式。OpenAI不再开源模型权重,而是通过API提供服务。这个决定改变了AI行业的格局——从"人人都能训练模型"变成了"少数公司提供AI能力"。
认知层面,它让更多人相信scaling这条路是对的。GPT-3不是一个精巧的算法创新,它就是"更大"。但"更大"居然带来了质的飞跃。这让整个行业投入了前所未有的资源到规模化竞赛中。
GPT-3之后发生了两件大事:一是OpenAI用RLHF对GPT-3进行对齐训练,诞生了ChatGPT;二是开源社区开始疯狂追赶,LLaMA、Mistral、Qwen等模型相继出现。
但这些都是后话了。GPT-3本身的意义在于:它是第一个让人感觉到"这可能真的是通向通用人工智能的一条路径"的模型。不是因为它做得多么好,而是因为它展示了一种前所未有的通用性。
一个模型,一个目标,1750亿参数。这就是GPT-3的故事。
kk的大模型论文学习笔记 · 第5篇 · GPT-3