📖 大模型论文学习笔记 · 阶段三 · 第11篇
1.3B 打败 175B。这件事比它听起来更反直觉:不是「小模型也很强」,是「大模型很强但你不懂怎么用」。预训练给模型的是能力,对齐给模型的是可用性。一个能力极强但完全不可用的模型,在生产环境里等于不存在。
kk的大模型论文学习笔记 · Stage 3 对齐与人类反馈 · 第1篇
能力很强,就是没法用
2020年,GPT-3横空出世。1750亿参数,写代码、写文章、做翻译,样样能来。但你用过就知道——它有一个要命的问题:能力很强,就是没法用。
你让它写一封礼貌的邮件,它给你续写成垃圾广告。你问它事实性问题,它一本正经地胡说八道。你让它注意安全,它毫不介意地输出有害内容。从「能生成」到「能被使用」,中间有一道工程鸿沟。而且这道鸿沟,不是把模型再做大一百倍就能填平的。
这就好比一个清华毕业的新人,代码能力极强,但写出来的东西在code review里过不了——commit message格式不对、变量命名随性、该写注释的地方不写。不是能力不行,是不懂规矩。GPT-3就是这个新人。
2022年3月,OpenAI发表了这篇论文:Training language models to follow instructions with human feedback。这篇论文给出的方案,就是后来ChatGPT的核心技术栈。而它证明了一件反直觉的事:
模型能力和模型可用性,是两个维度。它们可以解耦。
对齐问题:让人类偏好成为指挥棒
InstructGPT要解决的是对齐(Alignment)——让模型的行为和人类的意图、价值观保持一致。
OpenAI把这个目标拆成了三个维度:
Helpful(有用)——模型应该真正帮用户解决问题,而不是答非所问。
Honest(诚实)——模型应该说实话,不确定的时候承认不确定,而不是一本正经地编造。
Harmless(无害)——模型不应该输出有毒、歧视性、危险的内容。
三个H,简单明了。但问题在于:原始GPT-3的训练目标只有一个——预测下一个token。这个目标和「有用、诚实、无害」之间,隔着一道巨大的鸿沟。
这就好比一个API,它的核心指标只有QPS。QPS再高,如果接口设计烂、错误码混乱、文档缺失,在线上照样没法用。预训练是QPS,对齐是接口设计。
InstructGPT给出的答案是:用人类反馈来做强化学习(RLHF,Reinforcement Learning from Human Feedback)。整个方案分三步。
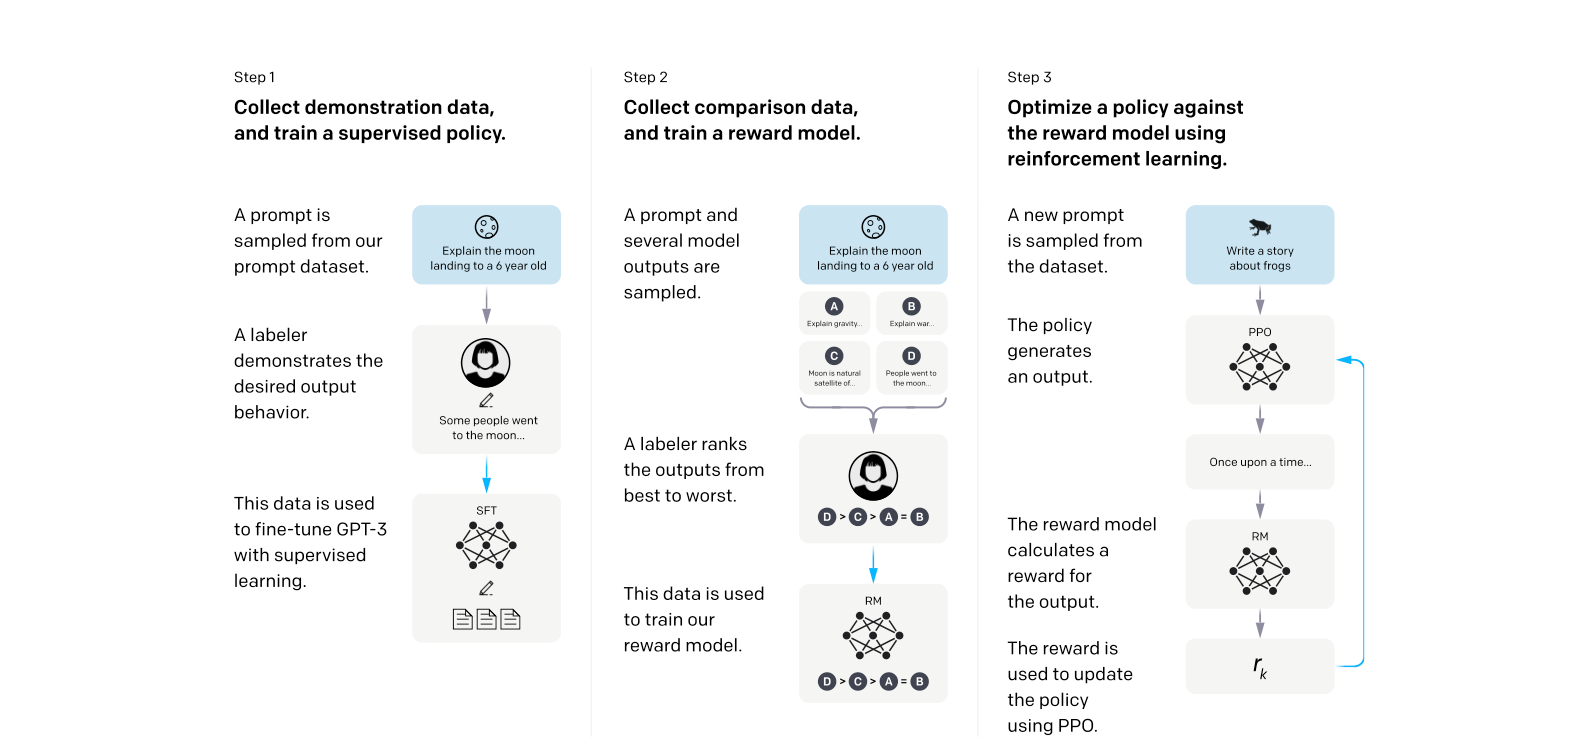
RLHF三步训练流程:SFT收集人类演示数据→训练奖励模型→PPO强化学习优化(来源:原论文 Figure 2)
第一步:SFT——不是教知识,是教规矩
SFT,Supervised Fine-Tuning,监督微调。
这一步的逻辑很直接:你想让模型学会怎么回答问题,最简单的办法就是——让人写标准答案给它学。
OpenAI收集了一批用户提交给GPT-3 API的prompt,雇了大约40个标注员,为这些prompt写出理想的回答。用这些(prompt, 理想回答)的配对数据去微调GPT-3,模型就学会了:哦,原来这种问题应该这样回答。
预训练是通识教育,SFT是onboarding。GPT-3在大学里学了四年(预训练),什么都会。但入职第一天,它需要有人告诉它:这个团队的代码规范是什么、commit message怎么写、code review的规范是什么。标注员的理想回答,就是这份「新员工手册」。
SFT之后,模型的输出已经有了质的飞跃——至少它知道要「回答问题」而不是「续写文本」了。但还不够。因为标注员写的标准答案也有质量高低之分,而且不可能覆盖所有场景。你需要一个更系统的质量控制机制。
第二步:Reward Model——把稀缺判断力蒸馏成可无限调用的函数
这一步,是整个方案中最精妙的设计。
问题摆在这:SFT之后的模型,面对同一个prompt可以生成很多种不同的回答。有些好,有些差。怎么告诉模型哪个好?
一个直接的想法是:继续让人类逐条打分。但这是线性成本——prompt越多,需要的人力和时间越多,不可持续。
OpenAI换了一个思路:让人类做排序(A比B好),然后用这些排序数据训练一个模型来模拟人类的判断。
具体流程:
-
给SFT模型一个prompt,让它生成4到9个不同的回答。
-
让标注员对这些回答进行排序——从最好到最差。
-
用这些排序数据训练一个Reward Model(奖励模型)。这个模型的输入是(prompt, 回答),输出是一个分数,代表人类对这个回答的偏好程度。
这个设计的核心洞察,用一句话说就是:人类标注是线性成本,Reward Model是一次性摊销。
一旦训练好,这个6B参数的Reward Model就是一个7x24小时不休息的「品味裁判」。它可以把人类在标注阶段投入的判断力,蒸馏成可以无限次调用的打分函数。
做过分布式系统的工程师应该很熟悉这个模式:你不可能每次请求都查主库,所以你做缓存。你也不可能每次生成都问人类,所以你训练RM。本质上都是把稀缺资源的一次性投入,转换成无限次的廉价调用。
还有一个关键细节:排序比生成容易得多。让人类写一段完美的回答是创作——耗时、主观、难以规模化。让人类说「A比B好」是二选一——快、客观、可以流水线化。OpenAI选对了任务的难度层级。
这个损失函数,用大白话说就是:让好的回答和差的回答在分数上尽量拉开距离。形式化地写,就是 Bradley-Terry 模型的负对数似然——对于每一对排序(回答A优于回答B),最大化「A得分减B得分」经过sigmoid后的概率。你把它理解成「裁判给两个选手打分,要求好选手的分数必须明显高于差选手」就够了。
这个RM用GPT-3的6B参数版本初始化,去掉最后的unembedding层,换成一个输出标量的线性层,在比较数据上微调。为什么是6B?论文试过更大的RM,发现收益递减——RM再大,判断力提升有限,反而拖慢PPO阶段的推理速度。6B在工程上刚刚好:判断力够用,推理不拖后腿。
第三步:PPO——用「裁判」的评分来优化模型
有了Reward Model这个裁判,下一步就是让SFT模型根据裁判的反馈来不断改进自己。这里用的是强化学习中的PPO算法(Proximal Policy Optimization)。
流程:
-
SFT模型(现在叫policy)接收一个prompt,生成一个回答。
-
Reward Model对这个回答打分,给出奖励值。
-
用PPO算法更新policy的参数,让它下次生成回答时能获得更高的奖励。
同时,PPO加了一个重要的约束:别跑太远。更新后的policy和原始SFT模型之间的KL散度不能太大。这样既优化了奖励,又不会让模型行为发生剧烈偏移。
为什么要加这个约束?如果去掉KL惩罚,模型会学会一个捷径:reward hacking。Reward Model毕竟只是一个6B的神经网络,它有盲区。如果不加约束,policy会很快学会生成一些「RM觉得高分但人类看了觉得荒唐」的回答——比如反复输出「这是一个很好的回答」这种毫无信息量但对RM来说得分很高的文本。KL惩罚的作用就是告诉模型:你可以优化,但不能偏离原始行为太远,偏离得太远说明你在钻空子。
这在工程上太常见了——你设了KPI,团队就开始刷KPI而不是真正解决问题。Reward Model的分数就是KPI,KL惩罚就是防止刷KPI的护栏。
在具体实现上,PPO阶段是这样跑的:每轮随机抽512个prompt(batch size),模型逐个生成回答,RM逐个打分,然后用这512个分数算出一个梯度,更新一次模型参数。这样的一轮叫一个episode——论文跑了约100万个episode,相当于模型被RM反复「批改」了100万次作业。
还有一个容易被忽略但很关键的设计:pretraining mix。
问题出在这里:你拼命教模型「说话要礼貌」「内容要安全」,模型很可能学过头——为了拿高分,它在安全回答上越来越擅长,但原来预训练阶段学会的那些通用能力(阅读理解、推理、多语言)逐渐退化。就像一个人学了太多职场规矩,反而忘了怎么写代码。
解决方案很直觉:在对齐训练数据里混入一部分原始预训练数据。每轮PPO不只看RM的奖励,还要看模型在这些「老题目」上的表现。如果预训练能力掉了,就扣分。论文把这种带预训练保护的版本叫PPO-ptx——相当于告诉模型:你可以学新规矩,但原来的手艺不能丢。
三步走完,InstructGPT就诞生了。SFT教了基本姿势,Reward Model定义了好坏标准,PPO在这个标准下持续优化。
最反直觉的结论:1.3B碾压175B
这篇论文最让人瞠目结舌的结果是:
在人类评估者的偏好测试中,参数量只有13亿的InstructGPT,其输出被偏好程度超过了拥有1750亿参数的原始GPT-3。
让我把这句话再读一遍。13亿,对1750亿。小了一百多倍。但在人类评估中,小模型赢了。
这个结论的冲击力在于:它把「模型能力」和「模型可用性」解耦了。
在很长一段时间里,大家默认两者是绑定的——更大的模型自然更好用。InstructGPT证明这是错的。这就好比,一个API的性能和它的接口设计是两回事。你可以有一个极其高性能但接口设计极烂的服务,它在生产环境里一样没法用。
对齐不是锦上添花,是把「能用」变成「好用」的必经之路。1.3B的InstructGPT赢的不是能力,是可用性。
当然,这并不是说规模不重要。InstructGPT的能力底座仍然是GPT-3的预训练。它只是在预训练的基础上加了一个对齐层。但这个对齐层的效果,远超很多人的预期。
写在最后
InstructGPT之后,做大模型的人被迫面对一个尴尬的事实:你训出来的模型再强,用户觉得不好用就是不好用。在此之前,整个行业默认「更强的模型必然带来更好的产品」。这篇论文证明这是两码事。
技术能力和产品可用性之间的那道裂缝,RLHF是第一个认真去填的人。